S’il y a un type d’intelligence artificielle qui m’a toujours beaucoup tenté, ce sont les algorithmes génétiques. L’idée de pouvoir créer un environnement où les entités ne seraient pas régies par un simple algorithme mais par un « instinct » qu’elles se seraient elles-même forgé par apprentissage est, je dois dire, bien séduisante. Bon par instinct on se comprend, en tous cas un comportement que chaque entité a appris d’elle-même.
Bon, il peut y avoir débat quant à la qualification d’intelligence artificielle des algorithmes génétiques. Il s’agit le plus souvent d’une simple optimisation de la recherche de solution. Mais en poussant bien, et parfois en le couplant à d’autres formes d’IA, il est possible d’avoir une entité dont le comportement évolue voire créer un écosystème dans lequel on observe des comportements émergents.
Déjà, c’est quoi ??
L’idée de base, c’est d’implémenter les principes de la sélection naturelle en code. On créer une population, on la teste, on sélectionne ce qui se rapproche le plus de ce qu’on attend, on reproduit, on ajoute un poil d’aléatoire et rebelotte.
Ça demande donc de pré-programmer une certaine quantité de « gènes » de base, donc des comportements pré-configurés. Mais les comportements en questions et les valeurs de leur paramètres seront sélectionnées au fur et à mesure, ce qui donnera un côté un tantichouille plus « biologique » à nos entités.
En concret ?
C’est justement ce qu’on verra aujourd’hui. Pour ne pas aller trop loin, on va faire un exercice simple : retrouver une phrase.
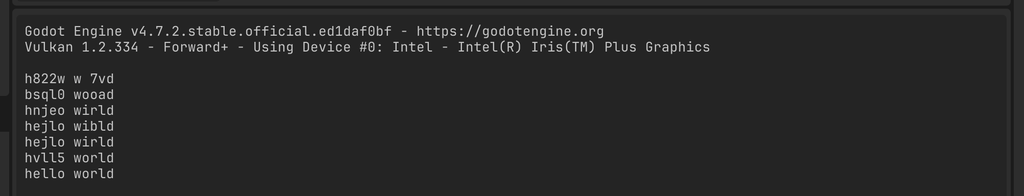
On va donc créer une chaîne de caractère (au hasard complet, on va travailler sur « hello world »), puis générer des chaînes aléatoires. On va noter les ressemblances, garder les meilleures puis appliquer le process décrit ci-dessus. C’est parti ? C’est parti !
Parlons peu, parlons code : les variables
Je vais vous étonner, mais exceptionnellement, on fera du GDScript aujourd’hui. L’idée finale étant d’apprendre à une entité à marcher, même si nous ne nous servirons pas du tout de 3D aujourd’hui, on va quand même prendre les bons réflexes et faire ça sur Godot. L’idée de cet article est de toutes façons de présenter toute la logique derrière les algorithmes génétiques, donc vous aurez de quoi traduire ce code en ce que vous voulez par la suite.
Tout d’abord, déclarons quelques variables. On aura besoin :
- D’une cible = la phrase qu’on veut pouvoir retrouver
- D’une liste de gènes = les caractères possibles dans notre phrase
- Le taux de mutation (quelle chance a un caractère d’être muté sans avoir rien demandé)
- La taille de notre population (ça dépend de votre machine, mais plus la population est grande, plus on a de chance d’avoir de « bons gènes »)
- La taille de nos tournaments, on en reparlera
- Un compte d' »élites » qu’on veut pouvoir garder à chaque génération (si elles sont bien, ne changeons pas une équipe qui gagne)
- Le nombre de générations max : un garde fou pour quand on fera des tests, j’ai pas non plus un ordi dernière génération
extends Node

const TARGET = "hello world"
const GENES = ["a", "b", "c", "d", "e", "f", "g", "h", "i", "j", "k", "l", "m", "n", "o", "p", "q", "r", "s", "t", "u", "v", "w", "x", "y", "z", "0", "1", "2", "3", "4", "5", "6", "7", "8", "9", " "]
const MUTATION_RATE = 0.05
const POP_SIZE = 200
const TOURNAMENT_SIZE = 5
const ELITE_COUNT = 2
const MAX_GENERATIONS = 2000
On va partir sur ces valeurs de base, on fera quelques tests à la fin pour en comprendre certaines.
Et on va juste décrire nos individus, on va juste créer une classe qui stocke à chaque fois un génome (une string du coup vu que c’est ce qu’on cherche) et son « fitness », un score qui compare sa proximité avec ce qu’on cherche. On crée donc ce fichier Individual.gd
class_name Individual

var genome: String
var fitness: int

func _init(g: String, f: int) -> void:
	genome = g
	fitness = f
Et pour l’utiliser dans notre fichier principal, il suffit d’ajouter ça en haut de vos variables :
var Individual = load("res://Individual.gd")Jouons avec nos gènes
On va commencer par créer toutes les fonctions de base en expliquant leur fonctionnement, et on verra ensuite comment on assemble tout ça. Mais dans la logique le déroulé sera le suivant :
- On génère une population de 200 individus avec un génome aléatoire
- On fait des « tournois » dans lesquels on prend 5 individus au pif et on retourne le meilleur, ça sera notre champion
- On prend deux vainqueurs de tournois, et on les « reproduit » ensemble, en prenant au hasard 50% des gènes de chaque.
- On applique une légère mutation sur le génome produit, histoire de diversifier
- On fait ça 200 fois pour reproduire une population de même taille (parce que ça nous arrange)
- On les trie par ordre de proximité avec notre cible, et on regarde le meilleur
- On boucle jusqu’à ce que notre meilleur élément soit exactement notre cible
Donc normalement, vu qu’on prend les meilleurs à chaque fois et qu’on les mélange, on devrait se rapprocher de notre cible au fur et à mesure des générations.
On va commencer par très simple : on veut générer une population de base. Pour ça on va donc créer une fonction qui génère une string aléatoire depuis notre tableau de gènes. Et dans l’idée on va générer à chaque fois une string de la même taille que notre target, ce qui donne :
func random_genes() -> String:
	var genome: String = "";
	for i in TARGET.length():
		genome = str(genome, GENES.pick_random())

	return genome
Donc ici simplement : on boucle autant de fois qu’on a besoin de caractères, on en choisit un au hasard dans notre tableau de gènes possibles, on l’ajoute à notre génome et on retourne le tout.
Maintenant on veut calculer notre « fitness« , c’est à dire notre score de proximité avec la cible. On va faire simple : pour chaque caractère identique à la même position, on ajoute 1 au score. Un genre de mastermind quoi :
func fitness(genome: String) -> int:
	var c: int = 0
	for i in genome.length():
		if (genome[i] == TARGET[i]):
			c += 1
	return c
Vous me pardonnerez d’ailleurs tout au long de cet article le manque potentiel d’optimisation, je suis loin d’être expert en GDScript !
On va également vouloir une petite fonction de mutation. On en reparle à la fin mais dans l’idée : on parcours tout notre génome et sur chaque gène on décide si on le mute ou pas avec un autre gène pris aléatoirement dans notre tableau. Comme on a une fonction randf() qui permet de générer un float entre 0 et 1, c’est parfait. Même si notre MUTATION_RATE est stocké en variable, on va quand même le passer en paramètre pour si on veut faire des tests sur la fin (ce qu’on ne fera pas ici, mais avouez que ça peut être pratique) :
func mutate(genome: String, mutation_rate: float) -> String:
	var new_genome: String = genome
	for i in genome.length():
		if randf() < mutation_rate:
			new_genome[i] = GENES.pick_random()
	return new_genome
Et maintenant, « the most ambitious crossover event in history » : la reproduction de deux individus ! On va faire simple pour l’instant même si ça ne correspond pas à une vraie reproduction: on va boucler autant de fois qu’il y a de gènes et on choisira aléatoirement un des deux gènes parent. Autrement dit au lieu de prendre 50% des gènes de l’un et 50% des gènes de l’autres, on prendra chaque gène avec 50% de chance chez l’un ou l’autre. Ça n’aura qu’un faible impact sur ce modèle mais on fera sans doute plus propre quand on en viendra à de « vrais » individus. Ou pas, j’en suis pas encore là.
func crossover(a: String, b: String) -> String:
	var new_genome: String = ""
	for i in a.length():
		if randf() < 0.5:
			new_genome = str(new_genome, a[i])
		else:
			new_genome = str(new_genome, b[i])
	return new_genome
Et maintenant nos tournaments ! Pareil ça va être simple : on duplique notre population (parce que GDScript passe des références en params, pas des valeurs, attention !), on boucle autant de fois que notre TOURNAMENT_SIZE pour choper autant d’individus aléatoirement, qu’on supprime de notre copie de la population pour être sûrs de ne pas avoir deux fois le même. Ensuite on retourne celui dont le fitness est le plus grand.
On notera que potentiellement on pourra avoir au sein d’une même génération plusieurs fois le même gagnant d’un tournoi, voire se retrouver dans un cas où on lance le crossover avec le même génome dans les deux params. Encore une fois : on fera plus propre plus tard mais ça n’aura que peu d’incidence ici !
func tournament_select(population: Array[Individual], tournament_size: int) -> Individual:
	var selected: Array[Individual] = []
	var pop = population.duplicate()

	for i in tournament_size:
		var index = randi() % pop.size()
		selected.push_back(pop[index])
		pop.remove_at(index)

	selected.sort_custom(func(a, b): return a.fitness > b.fitness)

	return selected[0]
Oui j’ai fait simple. On trie par ordre de fitness, et on retourne le premier.
Population et générations
Pour générer notre population rien de plus simple : on crée un array prêt à les accueillir, on boucle autant de fois que notre POP_SIZE, on génère un génome aléatoire, on crée notre individu avec et on le push dans notre array de population :
func run(mutation_rate: float, tournament_size: int, elite_count: int) -> int:
	var population: Array[Individual] = []
	for i in POP_SIZE:
		var g = random_genes()
		var individual = Individual.new(g, fitness(g))
		population.push_back(individual)
	population.sort_custom(func(a, b): return a.fitness > b.fitness)
	// le reste ira ici

	return generation
J’ai juste ajouté une subtilité : on trie par fitness avant de passer à la suite.
Maintenant on va boucler sur notre MAX_GENERATIONS (on fera un break avant si possible) et juste avant on crée une variable pour connaître le nombre de générations qu’on aura effectué avant d’arriver au bon résultat.
On crée une nouvelle variable pour accueillir la génération suivante, et on va simplement y ajouter nos X meilleurs candidats. Donc en dessous de notre génération de population, on ajoute :
var generation = 0
for i in MAX_GENERATIONS:
	generation += 1
	var new_pop: Array[Individual] = [];
	for j in elite_count:
		new_pop.push_back(population[j])
Super, maintenant on boucle jusqu’à arriver à notre taille de population (donc POP_SIZE – elite_count histoire d’arriver à 200). À chaque fois on lance deux tournois, on fait un crossover de nos deux génomes de champions et on applique une petite mutation dessus. Et on génère un Individu avec ça :
for j in POP_SIZE - elite_count:
	var g: String = mutate(crossover(tournament_select(population, tournament_size).genome, tournament_select(population
	, tournament_size).genome), mutation_rate)
	var child = Individual.new(g, fitness(g))
	new_pop.push_back(child)
Ensuite tout simplement, on remplace notre ancienne génération par la nouvelle (triste métaphore de la société, pardon) et on trie pour avoir les meilleurs en premier (idem) :
population = new_pop
new_pop.sort_custom(func(a, b): return a.fitness > b.fitness)
if (new_pop[0].fitness == 11):
	break
À la fin, notre fonction run ressemble donc à ça :
func run(mutation_rate: float, tournament_size: int, elite_count: int) -> int:
	var population: Array[Individual] = []
	for i in POP_SIZE:
		var g = random_genes()
		var individual = Individual.new(g, fitness(g))
		population.push_back(individual)
	population.sort_custom(func(a, b): return a.fitness > b.fitness)

	var generation = 0
	for i in MAX_GENERATIONS:
		generation += 1
		var new_pop: Array[Individual] = [];
		for j in elite_count:
			new_pop.push_back(population[j])

		for j in POP_SIZE - elite_count:
			var g: String = mutate(crossover(tournament_select(population, tournament_size).genome, tournament_select(population
			, tournament_size).genome), mutation_rate)
			var child = Individual.new(g, fitness(g))
			new_pop.push_back(child)

		population = new_pop
		new_pop.sort_custom(func(a, b): return a.fitness > b.fitness)
		if (new_pop[0].fitness == 11):
			break

	return generation
On lance et on analyse
Remplacez votre fonction _ready par ça :
func _ready() -> void:
	for i in 30:
		print(run(MUTATION_RATE, TOURNAMENT_SIZE, ELITE_COUNT))
Attachez le script à un gameobject de votre choix dans une scène, et lancez le jeu. Vous pouvez mettre des print() un peu partout pour un peu plus de woah, mais en regardant le nombre de générations on obtient quelque chose dans l’idée :
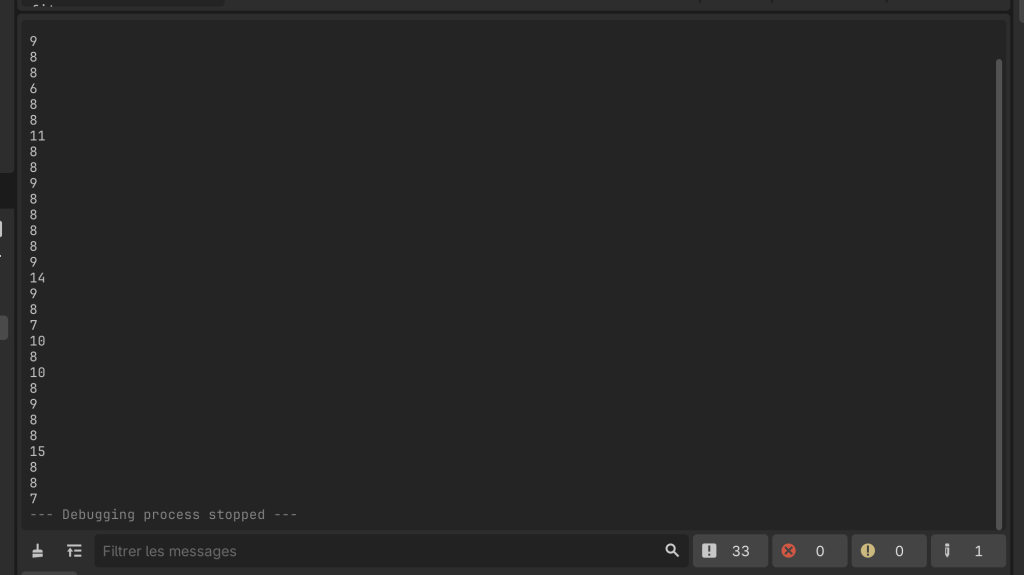
Et c’est là que jouer avec les paramètres peut devenir intéressants pour bien comprendre le fond des algorithmes génétiques. Alors je vous laisse avec ces questions :
- Que devient la moyenne quand on passe à 1000 de POP_SIZE ?
- Pourquoi autant de disparité quand on passe le MUTATION_RATE à 0 ?
- Pourquoi aussi peu de bons résultats quand on passe le MUTATION_RATE à 0.5 ?
