Dans l’article précédent on avait pu créer notre réseau de neurones avec une structure prête à l’emploi pour la reconnaissance de chiffres écrits à la main. Super ! Maintenant donnez-lui une donnée en entrée il n’en ressortira rien de bien intéressant. En effet, on a un étudiant prêt à passer son contrôle, mais on a oublié de lui donner cours. Alors cette fois c’est parti : on va coder un poil plus dur et apprendre à nos neurones comment apprendre !
J’enfonce une porte ouverte mais si vous n’avez pas lu l’article précédent et pas vu la vidéo conseillée dans son introduction, cet article ne vous apportera honnêtement rien de bien palpitant. Sur ce, démarrons !
Déjà, un peu de théorie
Une bonne partie de l’entraînement se fera en calculant de combien notre système se trompe et en adaptant en conséquence. En terme d’étapes on va être sur quelque chose dans l’idée :
- Déjà on fait traverser une image dans notre réseau neuronal
- On regarde notre résultat et on calcul de combien on se trompe
- On calcule via ça de combien on doit corriger notre couche
- On remonte vers la couche précédente pour calculer combien chaque neurone a contribué à l’erreur
- On met à jour les valeurs
- On recommence avec plus de données pour parfaire le réseau
Il va donc nous falloir une class spéciale pour l’entraînement de notre réseau de neurones. Alors ne perdons pas une minute, on relève nos manches et codons !
Parlons peu, parlons code
On va avoir besoin d’une petite dizaine de fonctions pour gérer tout ça alors on va faire progressivement. Déjà, calculons de combien on se trompe (humainement c’est dur je sais, mais promis c’est plus simple côté code) !
Encore une fois on ne s’attardera pas sur les mathématiques qui se cachent derrière, la chaîne proposée dans le premier article vous résumera tout ça mieux que moi. Ce qu’on doit donc transformer en code c’est ceci :
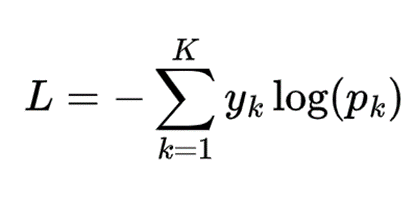
Donc on va récupérer deux tableaux : un de prédictions et un avec les résultats attendus. On va boucler dessus, multiplier le résultat par le log de notre prédiction et additionner aux résultats précédents. Go ? Encapsulons aussi tout ça dans notre nouvelle class de training :
<?php

class Training
{
	public function __construct()
	{ }

	public function crossEntropy(array $prediction, array $target): float
	{
		$sum = 0;

		foreach ($prediction as $k => $v) {
			$sum += -($target[$k] * log($v));
		}

		return $sum;
	}
?>
Génial. Maintenant qu’on a notre erreur, calculons comment cette info peut nous aider à corriger le poids d’un neurone. C’est là qu’entre en jeu la notion de « gradient ». Plus notre erreur est forte plus on corrigera et plus notre erreur est faible plus on ira doucement. Donc si un poids a un gradient de 0.5, on va un peu le diminuer, s’il a un gradient de -2, on va pas mal l’augmenter. Le tout en se basant sur une constante : notre « taux d’apprentissage » . Il va souvent de 0.01 à 0.1, c’est un peu le « pas » de notre correction. S’il est trop faible on apprendra trop lentement, s’il est trop fort on risque de « sauter » par dessus l’erreur minimum.
Pour résumer on va ici chercher à calculer deux choses : le sens et l’amplitude de notre correction. En code ça donne quoi ?
Et bien si c’est encore flou pour vous, bonne nouvelle : en fait pour notre couche de sortie tout ça on s’en fiche. Notre gradient sera juste la différence du résultat attendu et de notre prédiction (mais promis ça servira plus tard). Donc on prend simplement en paramètre nos deux tableaux, et on en sort un de différence :
public function outputGradient(array $prediction, array $target): array
{
	$out = [];

	foreach ($prediction as $k => $v) {
		$out[] = $v - $target[$k];
	}

	return $out;
}
Actuellement nous avons donc autant de gradient que de valeurs de sorties (dans notre cas 10 valeurs = de 0 à 9). Maintenant servons-nous de ce tableau pour modifier les poids de nos couches du dessus (donc les couches situées entre l’entrée et la couche de sortie).
L’erreur de la couche cachée
Ce qu’on a déjà c’est un nombre qui dit « mon score doit monter ou descendre, voici de combien !« , et ce pour chaque neurone de sortie. Or chaque neurone de sortie reçoit un signal de plusieurs neurones cachés. Donc il faut maintenant repérer lesquels sont responsables de l’erreur. Un neurone caché très actif a forcément beaucoup pesé dans l’erreur, et un éteint ou presque n’a normalement rien apporté. Donc on cherche à avoir un truc du style :
gradientCoucheCachée[neuroneSortieX][neuroneCachéY] = gradientCoucheSortie[neuroneSortieX] * valeursDeSortie[neuroneCachéY]
Ce qui va donner la fonction suivante :
public function outputWeightsGradient(array $gradientZ, array $a): array
{
	$out = [];

	foreach ($gradientZ as $k => $v) {
		foreach ($a as $j => $aj) {
			$out[$k][$j] = $v * $aj;
		}
	}

	return $out;
}
Maintenant on va vouloir calculer l’erreur de chaque neurone de cette couche. Parce qu’on a le gradient de la couche de sortie mais chaque neurone de notre couche cachée ne sait pas de combien il s’est trompé. Pour ça on va simplement boucler sur tout ça et multiplier le gradient de notre couche de sortie par le poids qui relie chaque neurone caché à ce neurone de sortie. Ça va donner un array à la structure étrange mais bien pratique :
public function hiddenError(array $weights, array $gradientZ): array
{
	$out = [];

	if (count($weights) === 0) return $out;

	for ($i = 0; $i < count($weights[0]); $i++) {
		$out[$i] = 0;
		foreach ($weights as $k => $v) {
			$out[$i] += $v[$i] * $gradientZ[$k];
		}
	}

	return $out;
}
Pour donner un exemple plus court et parlant de ce qu’on vient de faire, si on a ces valeurs en entrée :
W = [
[0.3, 0.2], –> neurone de sortie 0
[0.9, 0.9], –> neurone de sortie 1
]
gradient_z = [0.1, -0.2]
La sortie sera tout simplement : [(0.3 × 0.1 + 0.9 × (-0.2)), (0.2 × 0.1 + 0.9 × (-0.2))], donc [-0.15, -0.16].
Et comme tout à l’heure on a notre erreur, maintenant on veut notre gradient ! La subtilité en revanche c’est qu’ici on veut tenir compte de notre sigmoid. Parce qu’entre son score et sa sortie on avait branché un sigmoid donc on va devoir mesurer sa « raideur » (donc sa dérivée, histoire de vous replonger dans vos mauvais souvenirs de lycée).
La raideur de a, c’est tout simplement a × (1 – a). Donc notre fonction ressemble cette-fois à :
public function hiddenGradient(array $hiddenError, array $a): array
{
	$out = [];

	foreach ($hiddenError as $k => $v) {
		$out[] = $v * $a[$k] * (1 - $a[$k]);
	}

	return $out;
}
Maintenant on n’a plus qu’à calculer notre nouveau poids et notre nouveau biais.
Pour les biais rien de plus simple : on boucle sur notre tableau, et on soustrait à notre biais d’origine le gradient précédemment calculé et qu’on multiplie à notre fameux taux d’apprentissage qu’on avait laissé de côté tout à l’heure.
public function updateBiases(array $biases, array $gradients, float $learningRate): array
{
	$out = [];

	foreach ($biases as $k => $v) {
		$out[] = $v - $learningRate * $gradients[$k];
	}

	return $out;
}
Pour les poids en gros c’est pareil mais avec une dimension supérieure vu qu’on a affaire à une matrice. Donc dans ce cas aussi, ce qu’on veut c’est un tableau de sortie identique à notre tableau d’entrée en terme de format :
ublic function updateWeights(array $weights, array $gradients, float $learningRate): array
{
	$out = [];

	foreach ($weights as $k => $v) {
		foreach ($v as $j => $vj) {
			$out[$k][$j] = $vj - $learningRate * $gradients[$k][$j];
		}
	}

	return $out;
}
Et voilà ! Nous avons toutes les fonctions dont nous aurons besoin. Passons à la pratique !
Un grand pas d’apprentissage pour le PHP
Houston, nous avons un léger souci. C’est que pour notre training on a besoin de venir récupérer la sortie de la couche cachée, or pour l’instant notre fonction predict() de l’article précédent ne renvoie que la sortie de la couche finale. Donc transformons-donc notre NeuralNetwork comme suit pour garder predict intact mais pouvoir récupérer les couches intermédiaires. Et on ajouter un getter pour notre config :
<?php

class NeuralNetwork
{
    public function __construct(
        readonly private array $layersConfig
    ) { }

    public function predict(array $inputs): array
    {
        return $this->forward($inputs)[count($this->layersConfig) - 1];
    }

    public function forward(array $inputs): array
    {
        $currentInputs = $inputs;
        $outputs = [];
        foreach ($this->layersConfig as $config) {
            $layer = new NeuronLayer(
                $currentInputs,
                $config['weights'],
                $config['biases'],
                $config['activation']
            );
            $currentInputs = $layer->process();
            $outputs[] = $currentInputs;
        }
        return $outputs;
    }

    public function getLayersConfig(): array
    {
        return $this->layersConfig;
    }
}
On va créer une petite fonction utilitaire pour générer des weights aléatoires (l’idée c’est que le système affinera, mais faut bien commencer quelque part) :
public function randomWeights(int $inputSize, int $outputSize): array
{
	$weights = [];
	for ($i = 0; $i < $outputSize; $i++) {
		for ($j = 0; $j < $inputSize; $j++) {
			$weights[$i][$j] = (rand() / getrandmax()) - 0.5;
		}
	}

	return $weights;
}
On va donc créer une fonction trainStep qui prendra en paramètre un réseau de neurone pré-fabriqué, notre jeu de donnée, la target et notre learningRate. Ensuite on appelle nos fonctions dans cette ordre :
- forward
- outputGradient/outputWeightsGradient
- hiddenError
- hiddenGradient/outputWeightsGradient
- updateWeights/getLayersConfig (qu’on met directement dans un nouveau network)
Pas forcément de piège, il faut juste faire bien attention à quelle couche on passe en paramètre quand, et ça donne ceci :
public function trainStep(NeuralNetwork $nn, array $input, array $target, float $learningRate): NeuralNetwork
{
	$res = $nn->forward($input);

	$gradientZLast = $this->outputGradient($res[1], $target);
	$weightsGradientLast = $this->outputWeightsGradient($gradientZLast, $res[0]);

	$hiddenError = $this->hiddenError($nn->getLayersConfig()[1]['weights'], $gradientZLast);
	$gradientZHidden = $this->hiddenGradient($hiddenError, $res[0]);
	$weightsGradientHidden = $this->outputWeightsGradient($gradientZHidden, $input);

	$newNn = new NeuralNetwork([
		[
			'weights' => $this->updateWeights($nn->getLayersConfig()[0]['weights'], $weightsGradientHidden, $learningRate),
			'biases' => $this->updateBiases($nn->getLayersConfig()[0]['biases'], $gradientZHidden, $learningRate),
			'activation' => 'sigmoid',
		],
		[
			'weights' => $this->updateWeights($nn->getLayersConfig()[1]['weights'], $weightsGradientLast, $learningRate),
			'biases' => $this->updateBiases($nn->getLayersConfig()[1]['biases'], $gradientZLast, $learningRate),
			'activation' => 'softmax',
		],
	]);

	return $newNn;
}
Et il ne nous reste plus qu’à créer notre startTraining. On prend en paramètre nos data (tableau à deux dimensions qui contient les données d’une image et son résultat attendu) et notre learning rate. Ensuite on construit un premier réseau de neurone avec des données aléatoires. Enfin, on boucle X fois pour affiner peu à peu. Pour le moment ce chiffre importe peu, donc disons 300. Ce qu’on va faire c’est qu’on prendra une valeur aléatoire de notre data, on le normalise (on passe d’une valeur de 0 à 255 à une valeur de 0 à 1) et on appelle notre trainStep :
public function  (array $data, float $learningRate): NeuralNetwork
{
	$w = $this->randomWeights(25, 8);
	$b = [];
	for ($i = 0; $i < 8; $i++) {
		$b[$i] = 0;
	}

	$w2 = $this->randomWeights(8, 10);
	$b2 = [];
	for ($i = 0; $i < 10; $i++) {
		$b2[$i] = 0;
	}

	$nn = new NeuralNetwork([
		[
			'weights' => $w,
			'biases' => $b,
			'activation' => 'sigmoid',
		],
		[
			'weights' => $w2,
			'biases' => $b2,
			'activation' => 'softmax',
		],
	]);

	for ($i = 0; $i < 300; $i++) {
		list($pixels, $target) = $data[array_rand($data)];
		$input = array_map(fn($p) => $p / 255, $pixels);
		$nn = $this->trainStep($nn, $input, $target, $learningRate);
	}

	return $nn;
}
Pourquoi on prend une valeur aléatoire dans le tableau ? Parce qu’en faisant les chiffres au fur et à mesure (0, puis 1, puis 2) on pourrait « oublier » un chiffre dans la foulée. Avec l’aléatoire on garantit que chaque chiffre laissera une empreinte sur la durée.
Super, il ne nous reste plus qu’à créer des données. Ici, on crée juste 3 tableaux en 5*5 représentant 0, 1 et 7 histoire de tester, et on envoie le tout dans la moulinette :
<?php
require('./NeuronLayer.php');
require('./NeuralNetwork.php');
require('./Training.php');


$pixels0 = [
    0, 255, 255, 255, 0,
    255, 0, 0, 0, 255,
    255, 0, 0, 0, 255,
    255, 0, 0, 0, 255,
    0, 255, 255, 255, 0
 ];
$pixels1 = [
    0, 0, 255, 0, 0,
    0, 200, 255, 0, 0,
    0, 0, 255, 0, 0,
    0, 0, 240, 0, 0,
    0, 180, 255, 190, 0,
];
$pixels7 = [
    255, 255, 255, 255, 255,
    0, 0, 0, 0, 255,
    0, 0, 0, 255, 0,
    0, 0, 255, 0, 0,
    0, 255, 0, 0, 0
];
$target0 = [1, 0, 0, 0, 0, 0, 0, 0, 0, 0];
$target1 = [0, 1, 0, 0, 0, 0, 0, 0, 0, 0];
$target7 = [0, 0, 0, 0, 0, 0, 0, 1, 0, 0];
$data = [
    [$pixels0, $target0],
    [$pixels1, $target1],
    [$pixels7, $target7]
];

$training = new Training();
$trained = $training->startTraining($data, 0.1);
var_dump($trained->predict($pixels0));
J’ai récupéré mon réseau entrainé à la fin et je lui passe notre « image » d’un 0. Et on obtient le résultat suivant :
array(10) {
  [0]=>
  float(0.9749643396173466)
  [1]=>
  float(0.006347123527349602)
  [2]=>
  float(0.0009795171840397546)
  [3]=>
  float(0.0016497525929153975)
  [4]=>
  float(0.0012953176626894494)
  [5]=>
  float(0.001118841274699326)
  [6]=>
  float(0.0024643379270855217)
  [7]=>
  float(0.007864400898584667)
  [8]=>
  float(0.0016508610522908845)
  [9]=>
  float(0.001665508262998753)
}
Plutôt propre. Le système est sûr à ~97.5% qu’il s’agit d’un 0 ! On a donc un système fonctionnel prêt à être entraîné avec de vraies data. La prochaine fois on utilisera un vrai jeu, plus complet, et on testera sur le terrain !
